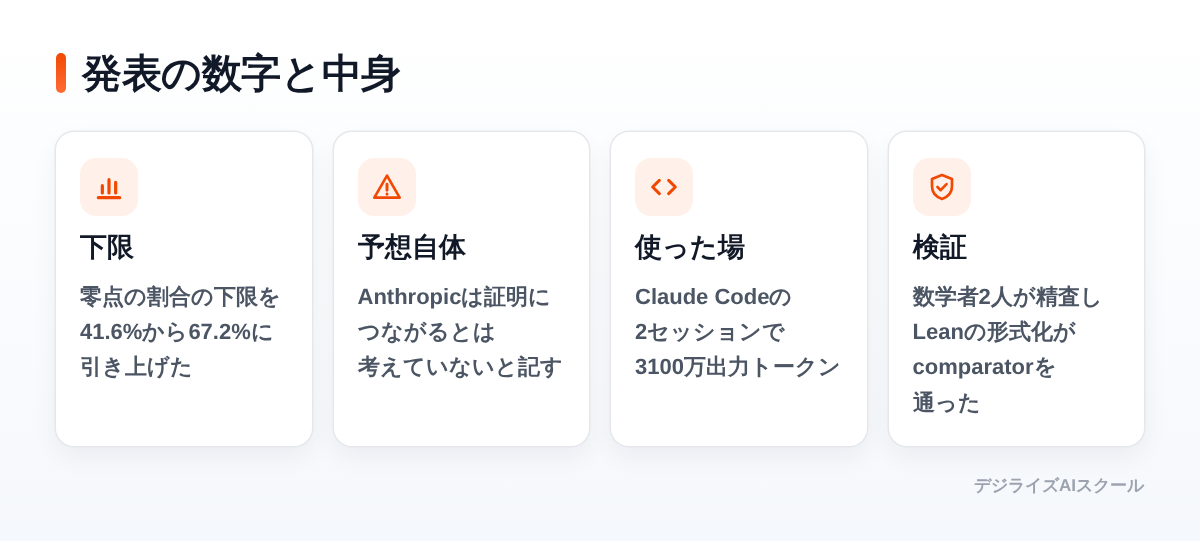
Anthropicは2026年8月10日に公開した研究記事で、未公開の研究版のClaudeが、リーマンゼータ関数の零点のうちリーマン予想を満たすものの割合の下限を41.6%から67.2%に引き上げたと説明しました。きっかけは社員がClaudeにリーマン予想そのものへ挑ませたことですが、Anthropicはその挑戦は成功しなかったと書いています。つまりClaudeがリーマン予想の証明を成し遂げたのではなく、関連する別の問題で記録が動いた、というのが公式の説明です。数学の話に見えて、この一件は「長い検証作業をAIに任せる」という働き方の見本にもなっています。
この記事で分かること
- Anthropicの研究記事に書かれた成果の中身と、出てくる数字の意味
- Claudeがどんな段取りでこの結果にたどり着いたか
- 人間の数学者と形式検証が、どこでどう関わったか
- 自分の仕事や社内の導入で、長い検証をAIに任せるときに確かめること
要点
- 未公開の研究版のClaudeが、リーマンゼータ関数の零点のうちリーマン予想を満たす割合の下限を41.6%から67.2%に引き上げた(公式ブログ)
- Anthropicは、Claudeが使った手法がリーマン予想の証明につながるとは考えていないと明記している
- 成果はClaude Codeの2つのセッションで見つかり、合計3100万出力トークンが使われた
- 2回目の試行では約60のサブエージェントを1日半かけて調整し、2,400のシェルコマンドと数百のPythonスクリプトが動いた
- Anthropicの数学者2人が論文を精査し、Leanによる形式化は標準の検証ツールcomparatorを通った
何が発表されたか
引き上げられたのは下限という数字
リーマンゼータ関数は素数の分布を表す関数で、関数の値が0になる場所(零点)がひとつずつ、素数の並びに細かい情報を加えていきます(公式ブログ)。リーマン予想は、素数を決めるその零点がすべて、ある垂直な直線の上に存在するという主張です。多くの結果が素数にランダムさを与えるためにこの予想を仮定しており、数学で最も影響の大きい予想のひとつになっています。リーマン予想は1859年にさかのぼり、100万ドルの賞金がかかっています。
まだ誰も証明も反証もできていない一方で、周辺の研究は進んできました。そのひとつが「直線上にある零点の最小の割合」を数で押さえる方向で、この既知の定数は時間をかけて41.6%まで引き上げられてきました。今回Anthropicが示したのは、未公開の研究版のClaudeがこの長年の下限を67.2%にしたという成果です(公式ブログ)。数十年にわたる数学者たちの広範な先行研究に依拠した結果だとされています。
その先行研究も具体的に挙げられています。1973年にMontgomeryがこの分野で新しい技法をいくつも導入しましたが、それらは予想が正しいと仮定していました。その後Aryan、続いてBaluyot、Goldston、Suriajaya、Turnage-Butterbaughの一連の研究が、その仮定なしでMontgomeryの技法を使えるようにしました。Claudeの結果はこの研究の流れと、2000年のBombieriの論文に大きく依拠しています。技術的には、Weilに由来する二次形式を備えた適切な関数空間を作り、二次形式の階数についての不等式を1次と2次のモーメントの情報で書き下す、という筋道だと説明されています。
Claudeがたどった段取り
この下限は、Claude Codeでの2つのセッションの中で見つかり、合計3100万出力トークンが使われました(公式ブログ)。指示を出したのはAnthropicの社員で数学者ではないJarred Sumnerで、「take a real stab」(本気でぶつかってみろ)と促し、そこから先の数学的な選択はモデルに委ねられました。
最初にClaudeは650個のアイデアを作って試しましたが、どれもうまくいきませんでした。もう一度やるよう促されたClaudeは、1日半をかけて約60のサブエージェントを調整し、今度はずっと深く進みました。サブエージェント全体で2,400のシェルコマンドを実行し、数百のPythonスクリプトを書いています。さらに、既知のゼータ零点に対して数千回の数値検査を行い、互いの作業を査読し合いました。役割の内訳も示されており、60のうち2つが鍵となる数学的アイデアを開発し、13がそのエージェントにアイデアを提供し、30は新しいアイデアを出そうとしたが出せず、13が議論の正しさを確かめる検証役を務め、最後の2つが最初の論文の執筆を手伝いました。
この間、Jarredの入力はほとんどが励ましのメッセージに限られていて、多くは「keep going」や「believe in yourself」の言い換えでした。Anthropicは、これがClaudeの当初の懐疑を乗り越える助けになったようだと書いています。Claude自身も自分の発見に最初は懐疑的だったと説明されています。似た励ましを含むプロンプトは、ClaudeがJacobian予想を反証する際にも使われたとされています。
人の検証と形式検証
見つけたあと、Claudeは自分の成果を自分で疑う作業もしています。別のサブエージェントに証明を点検させ、反例を探させ、arXivから54本の論文をダウンロードして同じ結果が既に出ていないかを確かめ、ゼロから独立に再証明させました。そしてClaudeは自ら論文として書くことを申し出て、人間の数論研究者に検証してもらうことを勧めています。
人の側では、Anthropicの数学者であるLevent AlpögeとRalph Furmanが、新しい結果と先行研究との関係を理解するために作業を精査しました。Anthropicの2人の数学者はClaudeの論文を検証し、専門家向けに証明を簡潔にまとめた非公式ノートを作っています。あわせて、この分野の専門家であるBrian ConreyとDan Goldstonが、短い通知で論文を調べてくれたことに謝意が示されています。形式面では、Claudeは形式的に検証可能な証明も作っており、別の社員Eric Easleyと協力したLeanによる形式化が、標準の検証ツールcomparatorを通りました(公式ブログ)。記事は2026年8月13日に、Claudeの論文の更新版を加えて更新されています。その論文はClaudeが改訂し、より明確な証明と歴史的背景を加えたものです。
変わる点と変わらない点
数字として変わった点
変わったのは「直線上にある零点の割合の下限」という具体的な数字です。41.6%から67.2%へ、という一点に尽きます。Anthropicはこの結果を、数学者のアイデアの射程をAIモデルが新しい形で広げられる例だと位置づけています。
変わっていない点
リーマン予想そのものは、証明も反証もされていません。Anthropicは、Claudeが使った手法がリーマン予想の証明につながるとは考えていないとはっきり書いています。今回の結果は、もともとの依頼から意図せず生まれた副産物だとも説明されています。見出しだけを読んで「解決した」と受け取らないことが、この話題でいちばん大事な線引きです。
| 項目 | これまで | 今回Anthropicが示したこと |
|---|---|---|
| 直線上の零点の割合の下限 | 時間をかけて41.6%まで引き上げられてきた | 41.6%から67.2%に引き上げた |
| リーマン予想そのもの | まだ誰も証明も反証もできていない | 挑戦は成功しなかった |
| Montgomeryの技法 | 1973年に導入され予想が正しいと仮定していた | 仮定なしで使える一連の研究に依拠した |
| 使われたClaude | 公式ページで確認 | 未公開の研究版のClaude |
| 作業の場 | 公式ページで確認 | Claude Codeの2セッション・3100万出力トークン |
| 検証 | 公式ページで確認 | 数学者2人が精査しLeanの形式化がcomparatorを通った |
個人の仕事や学びにどう使えるか
長い点検作業を分担させる
今回いちばん再現性があるのは「一つの難題を、たくさんのエージェントに分けて長時間かけさせる」という発想です。Claude Codeでは、タスクの別々の部分を同時に進める複数のエージェントを立ち上げられ、リードのエージェントが作業を調整し、サブタスクを割り当て、結果をまとめるとされています(公式ドキュメント)。エンジニアならテストの穴探しやログの突き合わせ、品質管理の担当なら手順書と実物の差分点検のように、手数が多くて退屈な点検は分担に向きます。プロジェクトの決め事は、プロジェクトのルートに置くマークダウンのファイルCLAUDE.mdに書いておけば、Claude Codeが毎回のセッションの最初に読み込みます。
既出かどうかの調べ物を任せる
Claudeは自分の発見が既出でないかを確かめるために、arXivから54本の論文をダウンロードしています。企画職やライター、研究職なら、この「既出チェック」の形はそのまま使えます。自分の案に近い前例を集めさせ、違いを一覧にさせてから、最後は人が読んで判断する流れです。社内の資料やチケットをつなぐなら、AIツールを外部のデータ源につなぐ公開標準であるMCP(Model Context Protocol)を使う道もあります。
繰り返しの作業を時間で回す
Claude Codeには定期実行の仕組みがあり、クラウドのスケジュールタスクはクラウド上で動くため、自分のパソコンの電源が切れていても動き続けるとされています。事務や運用の担当なら、朝の確認作業や週次の棚卸しのような繰り返しを載せる使い方が考えられます。ファイル編集の後の整形やコミット前の確認を自動で挟みたい場合は、Claude Codeの動作の前後でシェルコマンドを走らせるHooksが用意されています。
使い分けの考え方(目安)
| 作業 | 任せ方の例 | 出典にある裏付け |
|---|---|---|
| 長い点検や検算 | 複数エージェントに分担させる | 別々の部分を同時に進めるエージェントを立ち上げられる |
| 既出調べ | 資料を集めて突き合わせさせる | arXivから54本の論文を集めて既出でないか確かめた |
| 定期の繰り返し | スケジュール実行に載せる | クラウドのスケジュールタスクはPCの電源が切れていても動く |
| 最終判断 | 人が読んで決める | Claudeは人間の数論研究者による検証を勧めた |
企業で使うなら
導入時の注意点
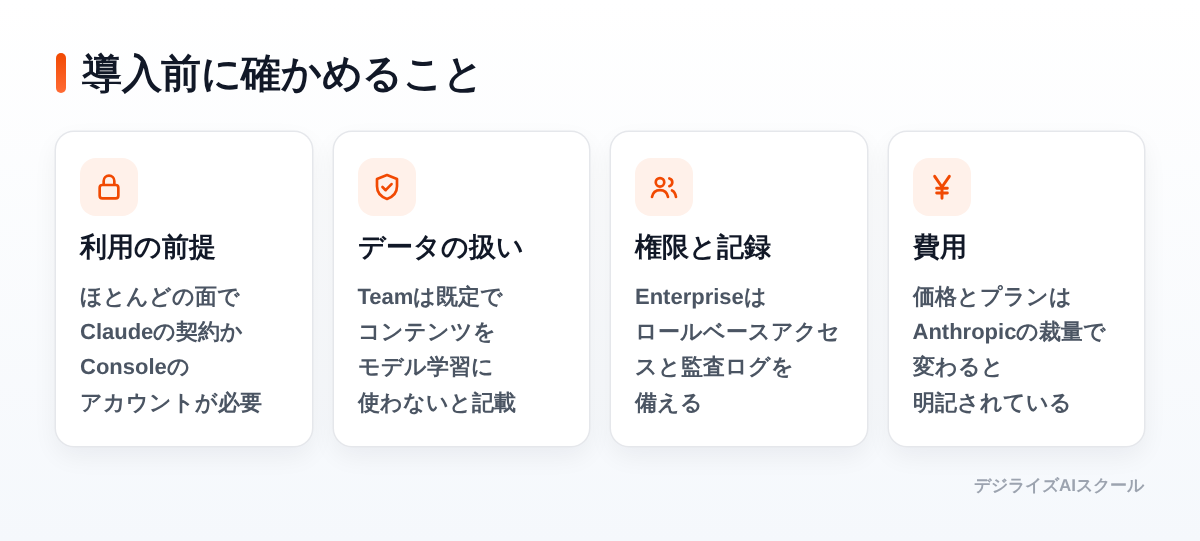
まず押さえたいのは、今回の成果を出したのが未公開の研究版のClaudeであるという点です。社内で同じ結果が出ると考えて計画を立てるのは危険で、検証の段取り(分担させる・反例を探させる・独立に再証明させる・人が精査する)のほうを持ち帰るのが現実的です。実行環境の前提も確かめておきます。Claude Codeはターミナル、IDE拡張、デスクトップアプリ、Webといった複数の面で動き、ほとんどの面でClaudeのサブスクリプションかAnthropic Consoleのアカウントが必要とされています。デスクトップアプリは有料のサブスクリプションが必要です。
データの扱いと権限は、プランによって書かれている内容が違います。Teamプランには、既定で自社のコンテンツをモデルの学習に使わないと記載があります(公式料金ページ)。Enterpriseプランには、管理者がユーザーと組織の支出上限を設定できること、細かい権限設定を伴うロールベースアクセス、監査ログ、独自のデータ保持期間の設定、観測と監視のためのCompliance APIが挙げられています。社内ルールを作るときは、誰がどの面からClaude Codeを動かせるのか、シェルコマンドを実行する作業をどこまで許すのかを、先に文章にしておくと混乱が少なくなります。
判断材料
費用は公開されている料金表で確認できます。個人向けはFreeが$0で、5時間ごとと週ごとの利用量に上限があります。Proは年払いで月$17($200を前払い)、月払いなら$20です。Maxは月$100で、5時間ごとと週ごとの利用量がProの5倍、Claude Platformで開発するための月$100分のAPIクレジットが付きます。Ultraは月$200で、週あたりの利用量がProの10倍、月$200分のAPIクレジットが付き、5時間の制限は認証済みアカウントで適用されません。チームで使うなら、Teamの標準シートは年払いで1席あたり月$20(月払いは$25)、プレミアムシートは月$100(月払いは$125)で標準シートの5倍の利用量です。Enterpriseは1席あたり月US$20の年払い・20席からで、利用料はモデルとタスクに応じて増えます。表示価格に税は含まれず、価格とプランはAnthropicの裁量で変更されることがあると明記されています。
API経由で動かす場合の単価も判断材料になります。料金表ではClaude Opus 5.5が入力100万トークンあたり$4・出力$20、Claude Sonnet 5.5が入力$2・出力$10と示されています。今回の作業で3100万出力トークンが使われたという数字と並べて読むと、長時間の自律作業は出力量が費用を左右することが分かります。モデル選びの目安として、迷う場合はほとんどの用途でClaude Opus 5.5から始めるよう案内があり、要求の高い推論や長時間のエージェント作業にはClaude Fable 5.2を使うよう書かれています。現行のモデルはいずれもテキストと画像の入力、テキストの出力、多言語、ビジョン、ツール利用に対応するとされており、Claude Opus 5.5は長時間のエージェント型のコーディングと知識労働向けと説明されています。法人での導入や社内研修の設計までまとめて相談したい場合は、株式会社デジライズに相談できます。デジライズは法人向けAIリスキリングサービスで導入社数No.1(東京商工リサーチ・2026年3月末時点)で、累計600社超・5万人以上のAI活用を支援しています。
| プラン | 月額の表記 | 書かれている主な条件 |
|---|---|---|
| Free | $0 | 5時間ごとと週ごとの利用量に上限 |
| Pro | $17(年払い・$200前払い)/月払い$20 | FreeのすべてにClaude Codeなどが加わる |
| Max | $100 | Proの5倍の利用量・月$100のAPIクレジット |
| Ultra | $200 | 週あたりProの10倍・月$200のAPIクレジット・認証済みは5時間制限なし |
| Team | 標準$20/席(月払い$25)・プレミアム$100(月払い$125) | 既定でコンテンツをモデル学習に使わない |
| Enterprise | US$20/席(年払い・20席から)+利用料 | 支出上限・ロールベースアクセス・監査ログ・データ保持期間の設定 |
使う前の注意点
今回の成果を出したのは未公開の研究版のClaudeで、作業はClaude Codeの2つのセッション、合計3100万出力トークンという規模でした。同じやり方を手元でそのまま再現する前提は置かないほうが安全です。また、Anthropic自身が手法の限界を述べていること、成果が意図しない副産物として生まれたことも、記事にはっきり書かれています。
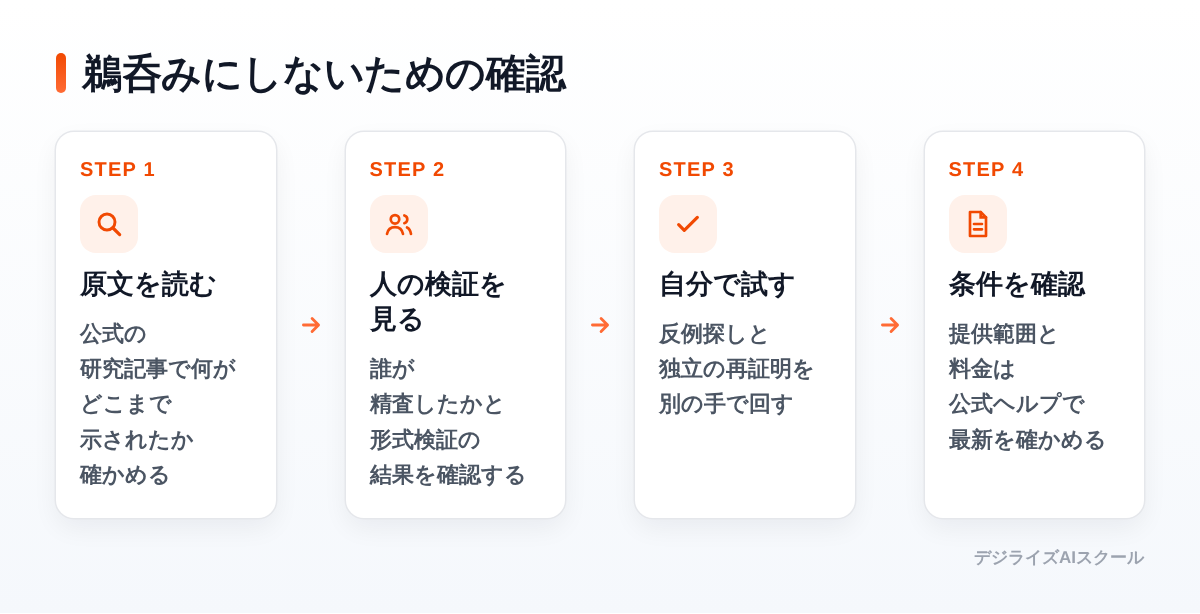
プロンプトの作り方についても、公式ドキュメントは前提を示しています。プロンプトエンジニアリングに入る前に、用途ごとの成功条件をはっきり定義していること、その条件に対して実証的に試す方法を持っていることが求められます(公式ドキュメント)。さらに、すべての成功条件や失敗した評価がプロンプトエンジニアリングで最もよく解決するわけではないとも書かれています。「励ませば伸びる」という話だけを真似ても、確かめる物差しがなければ結果の良し悪しは判断できません。
提供範囲や利用量の上限、データの扱いは変わりうるので、使う前にAnthropicの公式ヘルプセンターで最新の案内を確かめてください。ヘルプセンターには有料プランの比較と利用量の上限についての案内、データの扱いと規約・方針・コンプライアンスについての案内がまとまっています。日本での提供条件や日本語での対応範囲について気になる点がある場合も、公式のヘルプで最新の提供範囲を確認するのが確実です。
よくある質問
Claudeはリーマン予想を証明したのですか
Anthropicの研究記事では、Claudeはリーマン予想そのものには成功しなかったと書かれています。示されたのは、リーマンゼータ関数の零点のうちリーマン予想を満たす割合の下限を41.6%から67.2%に引き上げたという結果です。Anthropicは、Claudeが使った手法がリーマン予想の証明につながるとは考えていないとも述べています。見出しで「証明」と読める表現を見かけたときは、公式の研究記事の本文を確かめるのが確実です。
使われたのは今使えるClaudeですか
記事には、未公開の研究版のClaudeが新しい下限を見つけたと書かれています。作業の場はClaude Codeの2つのセッションで、合計3100万出力トークンが使われました。現在提供されているモデルの一覧や単価は、Anthropicの公式ドキュメントで確認できます。
正しさはどう確かめられたのですか
Claude自身が別のサブエージェントに証明を点検させ、反例を探させ、arXivから54本の論文を集めて既出でないかを確かめ、ゼロから独立に再証明させました。人の側ではAnthropicの数学者Levent AlpögeとRalph Furmanが作業を精査し、2人の数学者が論文を検証して専門家向けの非公式ノートを作っています。さらにBrian ConreyとDan Goldstonが論文を調べ、Leanによる形式化が標準の検証ツールcomparatorを通りました。
励ましのプロンプトには意味があるのですか
記事では、Jarredの入力はほとんどが励ましのメッセージに限られ、多くは「keep going」や「believe in yourself」の言い換えだったと書かれています。Anthropicは、これがClaudeの当初の懐疑を乗り越える助けになったようだとしています。似た励ましを含むプロンプトは、ClaudeがJacobian予想を反証する際にも使われたとされています。
自分の仕事でも同じ段取りが使えますか
数学の成果そのものは再現できませんが、段取りは参考になります。Claude Codeでは別々の部分を同時に進める複数のエージェントを立ち上げられ、リードのエージェントが作業を調整して結果をまとめるとされています。公式ドキュメントが求めているとおり、成功条件を先に決めて実証的に試す形にしておくと、長い作業を任せても結果を判断できます。
あわせて読みたい
- Cursorのルール設定|.cursor/rulesの置き場所と書き方と効き目の確かめ方
- Claude コネクタ設定の手順と権限の見直し方を公式情報で解説
- Claude Codeの権限設定 確認なし実行と拒否ルールの型
まとめ
- 未公開の研究版のClaudeが、リーマンゼータ関数の零点のうちリーマン予想を満たす割合の下限を41.6%から67.2%に引き上げた
- リーマン予想そのものは証明も反証もされておらず、Anthropicは今回の手法が証明につながるとは考えていないと明記している
- 作業はClaude Codeの2セッション・3100万出力トークンで、約60のサブエージェントが2,400のシェルコマンドと数百のPythonスクリプトを動かした
- 検証はClaude自身の点検に加え、Anthropicの数学者2人の精査、専門家2人の確認、Leanの形式化がcomparatorを通る形で行われた
- 持ち帰れるのは成果ではなく段取りで、成功条件を決めてから長い検証を任せる形が実務に近い
まずは手元の面倒な点検作業を一つ選び、成功条件を書き出してからClaude Codeに分担させてみてください。体系的に学びたい場合は、デジライズAIスクールのコース一覧や料金プランが参考になります。動画は990本以上あり、今回のような分担の考え方なら「5.マルチエージェントと自動化 ~ Claude~」が近いテーマです。
出典
- Claude has improved on a longstanding lower bound for the fraction of zeros of the Riemann zeta function that satisfy the Riemann hypothesis
- Plans & pricing | Claude by Anthropic
- Documentation
- Models overview
- Prompt engineering overview
- Overview - Claude Code Docs
- Home | Claude Help Center
この記事は、各社の公式の発表をもとに AI で下書きし、出典の本文との照合とGoogle 検索による事実確認(ファクトチェック)を通ったものだけを公開しています。